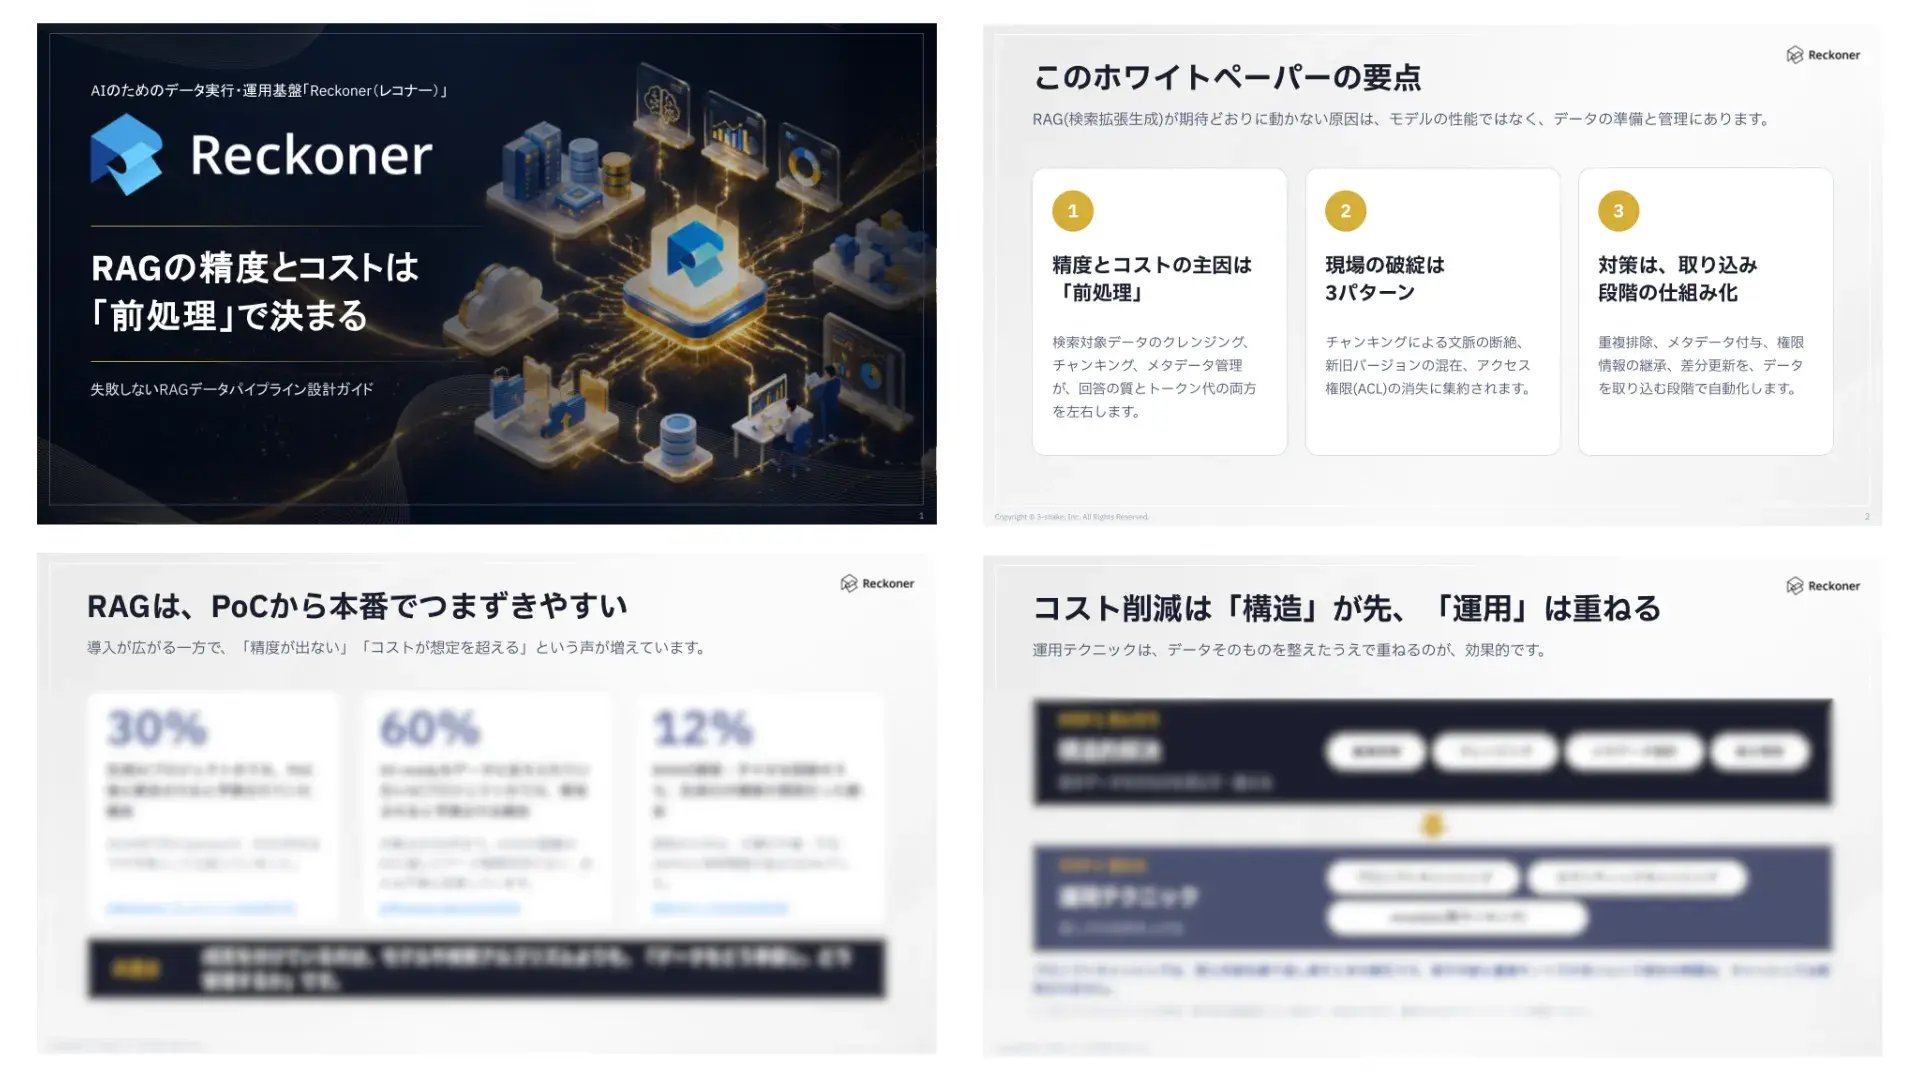
こんな内容の資料です
RAGの精度が上がらない、トークン代が想定より高い。その原因の多くは、LLMではなく、検索対象データの「前処理」にあります。現場で起きる破綻は、次の3つに集約されます。
- チャンキングで文脈が失われ、検索しても正しい情報が見つからない
- 新旧バージョンが混在し、古い情報で回答してしまう
- アクセス権限が引き継がれず、見えてはいけない情報が回答に出る
本書では、この3つの破綻と、トークンコストが膨らむ4つの原因を整理し、前処理をデータの取り込み段階で仕組みにする考え方を解説します。
自社のRAGがどこに当てはまるかを確認できるセルフチェックも収録し、どこから見直すべきかを見極められる内容になっています。
このような方におすすめです
- RAGのPoCはうまくいったが、本番で精度が出ない情シス・DX推進担当の方
- トークン代が想定を超えており、削減の進め方を探している方
- 社内文書の新旧バージョンの混在や、アクセス権限の管理に不安がある方
- AIエンジニアが少なく、データの収集・整形・更新を仕組みにしたい方